
스캔한 PDF, AI에 넣기 전 확인할 3가지
회의 자료 PDF를 AI에 올리고 “핵심만 정리해 줘”라고 했더니 문장은 매끄러운데 내용이 자료와 안 맞는 경험, 한 번쯤 있으실 겁니다. 날짜가 틀리거나, 원문에 없는 결론이 들어 있거나요.
원인은 프롬프트가 아닌 경우가 많습니다. 그 PDF 안에 글자가 아예 없었기 때문입니다. 스캔이나 사진으로 만든 문서는 겉으로는 글자처럼 보이지만, 파일 안에는 사진 한 장만 들어 있어요.
이 글에서는 파일을 올리기 전에 30초 안에 확인하는 방법과, 글자가 없을 때 되살리는 순서를 정리했습니다. 실제로 같은 파일에서 글자가 얼마나 뽑히는지 재 본 값도 함께 넣었습니다.
확인 범위 · 2026년 7월 29일 기준입니다. 추출량과 OCR 결과는 제가 맥에서 직접 실행해 측정했고, OCR 언어 데이터 설치 방식은 공식 문서 기준입니다. 아래 정확도 수치는 제가 만든 샘플 문서 기준이라 실제 스캔본과는 다를 수 있습니다.
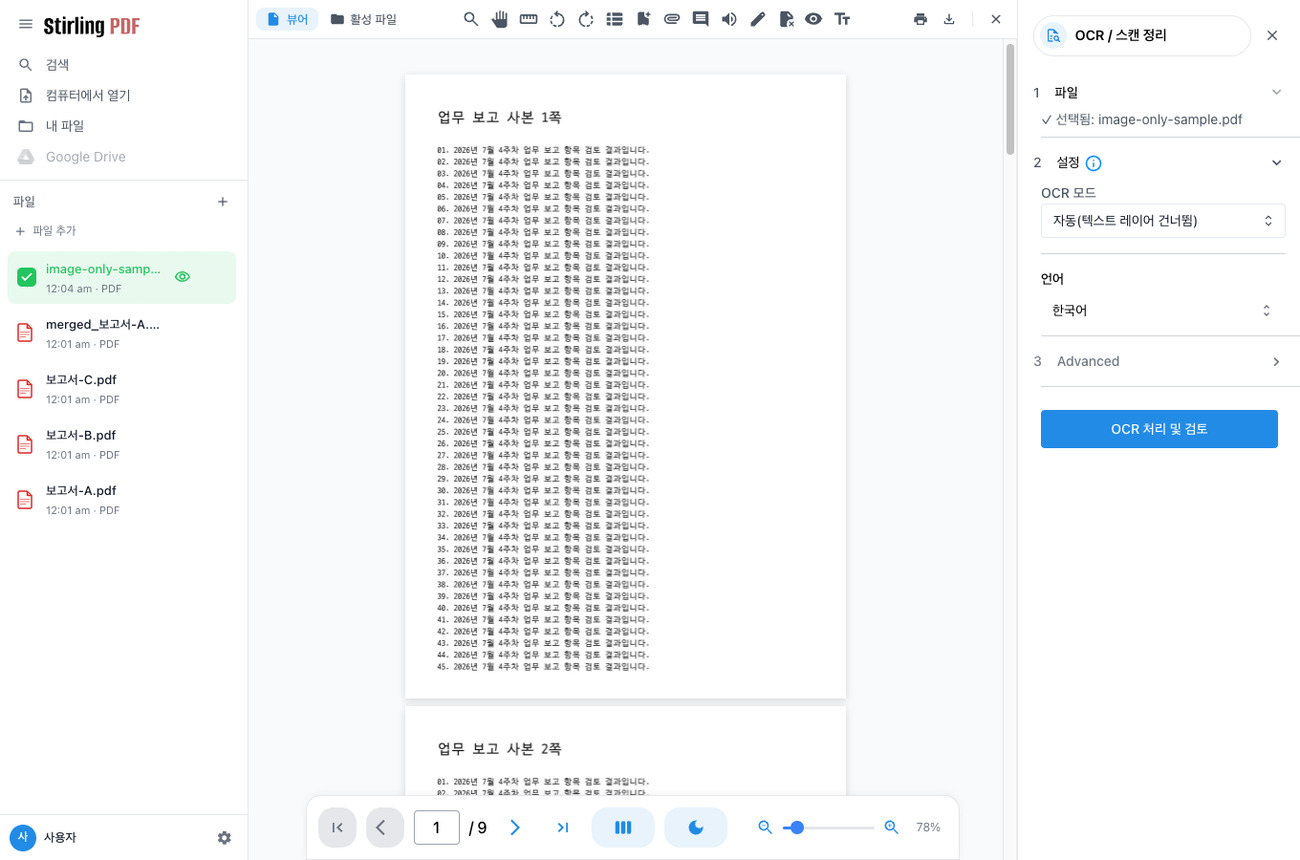
같은 9쪽 PDF에서 글자가 9바이트만 나오는 경우
먼저 숫자로 보겠습니다. 글자로 만든 3쪽 보고서에서는 8,868자가 뽑혔습니다. 반면 같은 내용을 사진으로 만든 9쪽 PDF에서는 9바이트, 사실상 아무것도 나오지 않았습니다.
쪽수는 세 배인데 뽑히는 글자는 0에 가깝습니다. 이 파일을 그대로 올리면 도구는 “읽을 것이 없다”고 알려 주는 대신, 파일명이나 앞뒤 맥락만 보고 그럴듯한 문장을 만들어 낼 수 있습니다.

30초 만에 확인하는 방법
특별한 도구가 필요하지 않습니다. PDF를 열고 본문 한 줄을 드래그해 보세요.
- 글자가 파랗게 선택되면 → 글자가 들어 있는 파일입니다. 그대로 진행하면 됩니다.
- 드래그가 사진처럼 네모로 잡히거나 아무것도 선택되지 않으면 → 사진으로 된 문서입니다.
Ctrl+F(맥은 Command+F)로 본문에 확실히 있는 단어를 검색해 보는 방법도 빠릅니다. “결과”처럼 분명히 보이는 단어가 0건으로 나오면 글자 층이 없다는 뜻이에요.
💡 애매한 파일도 있습니다. 표지는 글자인데 본문만 스캔인 문서처럼요. 이럴 때는 중간 쪽에서 한 번 더 확인하는 편이 안전합니다.
글자가 없으면 OCR로 층을 얹습니다
OCR은 사진 속 글자를 읽어서 이미지 위에 눈에 보이지 않는 글자 층을 덧붙이는 작업입니다. 겉모습은 그대로인데 복사와 검색이 되기 시작합니다.
여기서 한국어 문서를 다룰 때 꼭 걸리는 지점이 있습니다. 제가 로컬에 띄운 도구의 기본 상태에서 선택할 수 있는 OCR 언어는 중국어 간체, 독일어, 영어, 프랑스어, 포르투갈어뿐이었습니다. 한국어가 목록에 없었어요. 한국어로 실행하니 “선택한 언어가 유효하지 않다”는 오류만 돌아왔습니다.
해결 방법은 언어 데이터 파일을 넣어 주는 것입니다. 공식 문서 기준으로 Tesseract 언어 파일(.traineddata)을 받아 /usr/share/tessdata 위치에 두면 되고, Docker로 쓴다면 폴더를 연결해 주면 됩니다.
volumes:
  - /내가/받은/언어파일폴더:/usr/share/tessdata
⚠️ 공식 문서가 굵게 적어 둔 주의사항이 하나 있습니다. 기존 eng.traineddata는 지우지 마세요. 필수 파일입니다.
한국어 파일을 넣고 도구를 다시 시작하니 언어 목록에 한국어가 나타났습니다.
언어 파일은 두 종류가 있습니다. 공식 문서는 용량이 작고 빠른 쪽(tessdata_fast)은 인식 정확도가 낮을 수 있고, 용량이 큰 쪽(tessdata)은 정확도가 높지만 느릴 수 있다고 안내합니다. 정확도가 중요한 문서라면 후자를 받는 편이 낫습니다.
로컬 도구를 쓸 수 없는 환경이라면 클라우드 OCR도 선택지입니다. 다만 그 순간 파일이 외부 서버로 올라가니, 문서에 무엇이 들어 있는지부터 판단해야 합니다.
OCR을 돌린 뒤에도 그대로 믿지 않는 이유
9쪽 문서에 한국어 OCR을 걸어 봤습니다. 9.6초가 걸렸고, 뽑히는 글자는 9바이트에서 33,152자로 늘었습니다. 검색과 복사가 되기 시작한 겁니다.
그런데 내용을 열어 보니 그대로 쓸 수는 없었습니다. 원문 한 줄과 통째로 일치하는 줄은 한 건도 없었어요. “2026년”과 “검토”는 405줄에서 제대로 인식됐지만, 같은 줄에 있던 “4주차”와 “결과”는 한 번도 잡히지 않았습니다.
뽑아낸 텍스트를 그대로 옮기면 이런 모습입니다.
원문 한 줄
01. 2026년 7월 4주차 업무 보고 항목 검토 결과입니다.

OCR로 뽑힌 결과
2026년
검토
가
0 이
한 문장이 단어별로 쪼개지고, 인식하지 못한 자리에는 엉뚱한 글자가 들어갔습니다. 사람이 보면 바로 알지만, 요약을 맡기면 이 상태 그대로 읽힙니다.
| 상태 | 뽑히는 글자 | 파일 용량 |
|---|---|---|
| 사진으로 된 원본 (9쪽) | 9바이트 | 10.58MB |
| 같은 파일, 한국어 OCR 후 | 33,152자 | 15.06MB |
이 결과에는 조건이 붙습니다. 제 샘플은 실제 스캔본이 아니라 글자를 이미지로 바꿔 만든 문서이고, 글꼴도 폭이 일정한 코딩용 글꼴이었습니다. 게다가 용량이 작은 tessdata_fast 쪽 언어 파일을 썼습니다. 실제 스캔본에 정확도가 높은 언어 파일을 쓰면 결과는 더 좋아질 수 있습니다.
그래도 방향은 분명합니다. OCR은 “읽을 수 있게” 만들어 주지만 “맞게” 만들어 주지는 않습니다. 그래서 표본 확인이 필요합니다.
한 가지 더, 표에서 보이듯 OCR 후 파일이 10.58MB에서 15.06MB로 커졌습니다. 메일로 보낼 파일이라면 이 순서를 기억하세요. OCR을 먼저 하고, 용량은 그다음에 줄입니다. 줄인 뒤에 OCR을 걸면 흐려진 글자를 읽게 됩니다.
표본 확인에 쓰는 지시문
추출한 텍스트를 그대로 요약시키기 전에, 아래 지시문으로 상태를 먼저 물어보면 헛수고를 줄일 수 있습니다. 복사해서 쓰시면 됩니다.
아래는 PDF에서 추출한 텍스트입니다.
숫자, 날짜, 금액, 사람·회사 이름이 들어간 문장 5개를 원문 그대로 인용해 목록으로 뽑아 주세요.
빠진 글자를 추측해서 채우지 말고, 깨져 보이는 부분은 [불명]으로 표시하세요.
이 목록을 원문 화면과 눈으로 맞춰 봅니다. 세 곳 이상 어긋나면 그 문서는 요약 대상이 아니라 다시 만들 대상입니다.
상태가 괜찮다면 요약 단계에서도 근거를 함께 요구하는 편이 안전합니다.
요약하기 전에, 각 항목마다 근거가 있는 쪽 번호와 인용 문장을 함께 적어 주세요.
근거를 찾을 수 없는 항목은 '근거 없음'이라고 쓰고 요약에서 제외하세요.
개인정보는 올리기 전에, 내 컴퓨터에서 찾습니다
스캔 문서는 신분증 사본이나 계좌 정보가 함께 들어 있는 경우가 많습니다. 무엇을 지울지 찾는 일까지 외부 도구에 맡기면, 지우려던 정보를 이미 보낸 셈이 됩니다.
그래서 이 단계는 파일을 열어 둔 상태에서 찾기(Ctrl+F) 기능으로 끝냅니다. 아래 단어와 형식만 확인해도 대부분 걸러집니다.
- 숫자 형식:
-가 들어간 13자리, 계좌번호 자리수, 카드 앞 6자리 - 단어: 주민, 생년월일, 계좌, 예금주, 연락처, 휴대전화, 주소
- 문서 종류: 신분증, 가족관계, 등기, 급여, 인사
찾은 쪽은 아예 빼거나, 해당 부분을 가린 사본을 따로 만든 뒤 올립니다. 회사 규정상 문서를 외부로 보낼 수 없다면 글자 추출과 OCR까지는 내 컴퓨터에서 끝낼 수 있습니다.
올리기 전 확인 목록
- ☐ 본문 드래그로 글자가 선택되는가
- ☐ 중간 쪽에서도 같은지 확인했는가
- ☐ 한국어 문서인데 OCR 언어 목록에 한국어가 있는가
- ☐ 숫자·날짜·이름 3~5곳을 원문과 맞춰 봤는가
- ☐ 지워야 할 개인정보가 남아 있지 않은가
- ☐ OCR을 먼저 하고 용량 줄이기를 나중에 했는가
다음에 볼 것
여러 파일을 하나로 모으고 필요한 쪽만 남기는 단계는 PDF 합치기, 파일 업로드 없이 끝내는 2가지 방법에, 용량을 어디까지 줄여도 되는지는 PDF 용량 줄이기, 품질 값 1~9 실제 결과와 안전선에 정리해 두었습니다.
글자가 제대로 확보된 다음 단계, 즉 여러 자료를 근거와 함께 정리하는 방법은 NotebookLM으로 자료 조사 정리하는 법에서 이어집니다.
참고한 자료
- Stirling PDF 공식 문서 — OCR 언어 데이터 추가 방법과 주의사항 (2026-07-29 확인)
- Tesseract 언어 데이터 저장소 — tessdata / tessdata_fast (2026-07-29 확인)
- 추출량·OCR 결과는 동일 파일로 직접 실행해 측정 (2026-07-29)